

生成AIを導入したのに、思ったような答えが返ってこない。その原因は、AIの性能ではなく「データ」にあるかもしれません。
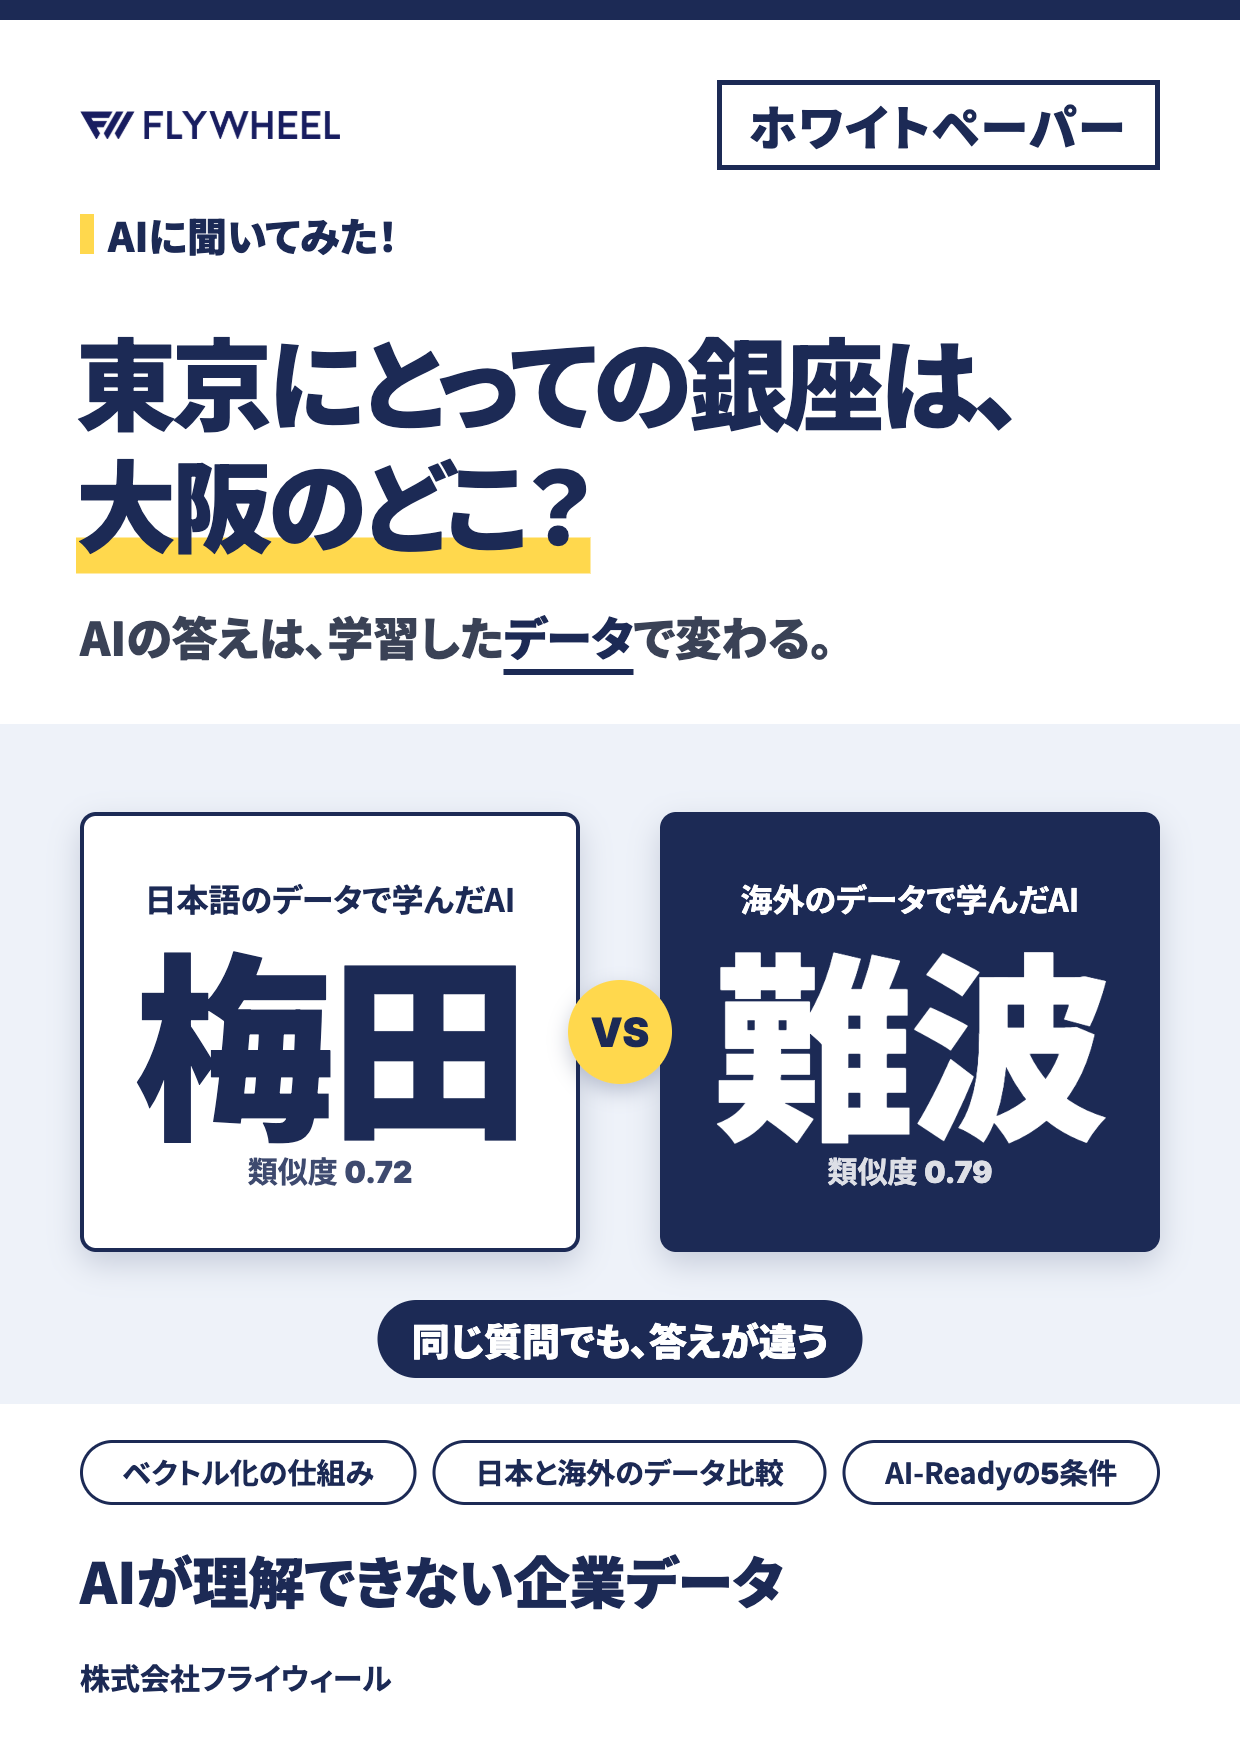
本資料では、AIが言葉の意味を理解する仕組み「ベクトル化」を、「りんご」と「みかん」の例でわかりやすく解説します。さらに、「東京にとっての銀座は、大阪にとってはどこ?」という問いを、日本語のデータと海外のデータで分析し、学習データが違うとAIの答えが変わることを実例で紹介します。
【この資料でわかること】
・言葉を「意味のある数字」に変換する、ベクトル化の仕組み
・同じ質問でも、参照するデータによってAIの答えが変わる理由
・AIを活かしきるデータ環境の5つの条件
【こんな方におすすめ】
・生成AIを導入したものの、回答の精度に課題を感じている方
・社内のデータをAIで活用するための準備を進めたい方
このカタログについて
| ドキュメント名 | AIが理解できない企業データ|生成AI時代の“見えない壁”を解き明かす【ホワイトペーパー】 |
|---|---|
| ドキュメント種別 | ホワイトペーパー |
| ファイルサイズ | 928.4Kb |
| 登録カテゴリ | |
| 取り扱い企業 | 株式会社フライウィール (この企業の取り扱いカタログ一覧) |
この企業の関連カタログ

このカタログの内容
Page1
「AIが理解できない企業データ」、
生成AI時代の“見えない壁”を解き明かす
〜「りんご」と「みかん」が示す、AIの“理解力”と“データ品質”の関係〜
株式会社フライウィール - FLYWHEEL, Inc.
Page2
言葉を
りんご
「意味のある数字」に
変換するAI の仕組み ?
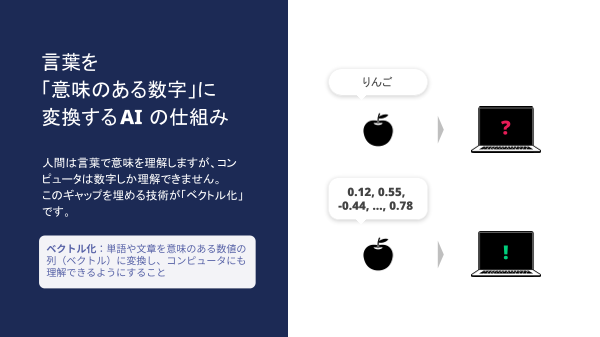
人間は言葉で意味を理解しますが、コン
ピュータは数字しか理解できません。
このギャップを埋める技術が「ベクトル化」 0.12, 0.55,
-0.44, ..., 0.78
です。
ベクトル化:単語や⽂章を意味のある数値の
列(ベクトル)に変換し、コンピュータにも !
理解できるようにすること
Page3
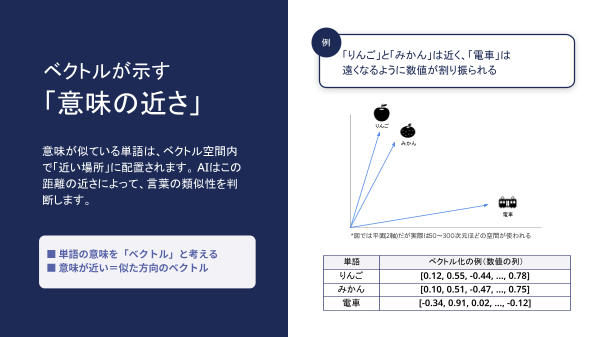
例
「りんご」と「みかん」は近く、「電車」は
ベクトルが示す 遠くなるように数値が割り振られる
「意味の近さ」
りんご
みかん
意味が似ている単語は、ベクトル空間内
で「近い場所」に配置されます。 AIはこの
距離の近さによって、言葉の類似性を判
断します。
電車
*図では平面(2軸)だが実際は50~300次元ほどの空間が使われる
■ 単語の意味を「ベクトル」と考える
■ 意味が近い=似た⽅向のベクトル 単語 ベクトル化の例(数値の列)
りんご [0.12, 0.55, -0.44, ..., 0.78]
みかん [0.10, 0.51, -0.47, ..., 0.75]
電車 [-0.34, 0.91, 0.02, ..., -0.12]
Page4
例 東京にとっての銀座は大阪にとってはどこか?
例えば「東京にとっての銀座は大阪にとってはどこか?」を人間に聞いたとき、
答えはその人の 住んでいる場所・生活様式・文化 によって変わります。
東京にとっての銀座は
大阪にとってはどこ? 梅田 難波 心斎橋
Page5
ベクトル化を使うと、類似度を数値で分析できる
日本語の Wikipedia のデータを基にベクトル化し、東京にとっての銀座に近いベクトル値(類推機能を使用)を
取り、類似度の近い都市を上位 7 つ 抽出します。
ランク 類推結果 類似度 備考
1位 梅田 0.72 大阪の代表的商業エリア
結果…
2位 心斎橋 0.70 高級・ブランド街として銀座に近い
梅田が最も近い
3位 難波 0.69 商業・観光の中心地
4位 天王寺 0.65 都市の副都心
5位 京橋 0.63 商業・再開発エリア
6位 本町 0.60 オフィス街だが中心地
使用モデル:gensim の Word2Vec
7位 阿倍野 0.59 百貨店などが集まる繁華街 使用データ:日本語Wikipediaコーパス
※他の学習データで試すと違う結果がでる可能性があります
Page6
使用するデータベースを変えると異なる結果に
一方で、海外のデータ(Google News Word2Vec)を使うと、東京にとっての銀座に近い大阪の街は難波に。
また日本のデータでは圏外だった道頓堀が海外では 4 位となっており、使用するデータソースによって認識の
違いがあることが分かります。
ランク 類推結果 類似度 備考
1位 namba 0.79 大阪の繁華街(難波)
海外の場合は…
2位 umeda 0.76 梅田:大阪の主要駅
難波が最も近い
3位 shinsaibashi 0.75 心斎橋:ブランド街
4位 dotonbori 0.73 道頓堀:観光地
5位 tennoji 0.70 天王寺:商業地
6位 abeno 0.68 阿倍野:大型モールもある
使用モデル:gensim の Word2Vec
7位 kyobashi 0.66 京橋:交通の要所 使用データ:Google News Word2Vec
※他の学習データで試すと違う結果がでる可能性があります
Page7
AI の言葉の理解は「データ」次第
「梅田」と「難波」のように、参照するデータソースが違えば答えも異なる結果になります。
どんな高度な検索技術(ベクトル化)も、元データが違えば、 AI の「常識」や「知識」は変化する。
AI の言葉の理解はデータ次第とも言えるでしょう。
Q. 東京にとっての銀座は大阪にとってはどこ?
日本語Wikipediaを元データにした場合 : 梅田 Google Newsを元データにした場合 : 難波
ランク 類推結果 類似度 ランク 類推結果 類似度
1位 梅田 0.72 1位 難波 0.79
2位 心斎橋 0.70 2位 梅田 0.76
3位 難波 0.69 3位 心斎橋 0.75
4位 天王寺 0.65 4位 道頓堀 0.65
使用モデル: gensim の Word2Vec 使用モデル: gensim の Word2Vec
使用データ:日本語 Wikipediaコーパス 使用データ: Google News Word2Vec
※他の学習データで試すと違う結果がでる可能性があります
Page8
90%*
AI を活かしきる 会社内の扱いづらい
⾮構造化データ
(⽂書/PDF等)
データ環境の AI-Ready データの 5 つの条件
5 01. 分かりやすい構造 → 構造化、モデリング
つの条件
02. 適切な意味づけ → ベクトル化、ラベリング
AI 活用を成功させるには、高度な検索 03. ⾼い品質 → 誤り‧偏りの少ないデータ
技術以前に、データそのものを 04. 統⼀された管理 → ガバナンス、セキュリティ
「AI-Ready」( AI が使いこなせる状態 )
に整備することが不可欠です。 05. 継続的な改善 → モニタリング&フィードバック
出典*:IDCホワイトペーパー、Box Inc:未開拓の価値:⾮構造化データについてあらゆ
る経営幹部が理解すべきこと 、Doc.US51128223、2023年8⽉
Conata Data Agentは「AI-Readyデータ環境」を短期間で構築できるプラットフォームです。
既存の⽂書‧ファイル‧表データを、企業独⾃の知識をAIが理解できる形に変換します。
8
Page9
今こそ、自社データを
“AIが理解できる言語 ” 貴社のデータ基盤の AI-Ready 度、診断しませんか?
に変えるときです。 \ AI-Ready診断 実施中!/
Conata Data Agent では、御社の社内
データをAIが適切に理解・活用できる状態 お問い合わせはこちら
へ変換する仕組みを実現します。
AI-Ready診断やPoCのご相談は、右のボタ
ンからお気軽にお問い合わせください。